

电商历史经营数据回溯采集往往涉及多个系统或岗位。实施时应围绕任务拆解、知识整理、权限控制和异常闭环展开,不能只比较模型参数或界面功能。
清晨九点,电商运营总监李明的手机弹出十几条未读消息。“老板,上周天猫新品的利润数据为什么还没出来?”“抖音大促那天的销售明细,财务这边急需核对入账。”他叹了口气,这已经是本周第三次被催数据了。团队五六个人,光是每天登录各平台后台、筛选时间维度、手动下载报表就要花去大半天时间,更别提还要将这些格式各异的Excel合并、清洗、计算。当他想回顾三个月前的某个爆款活动数据时,却发现当时的报表早已被淹没在文件夹的层层嵌套中,找都找不到。
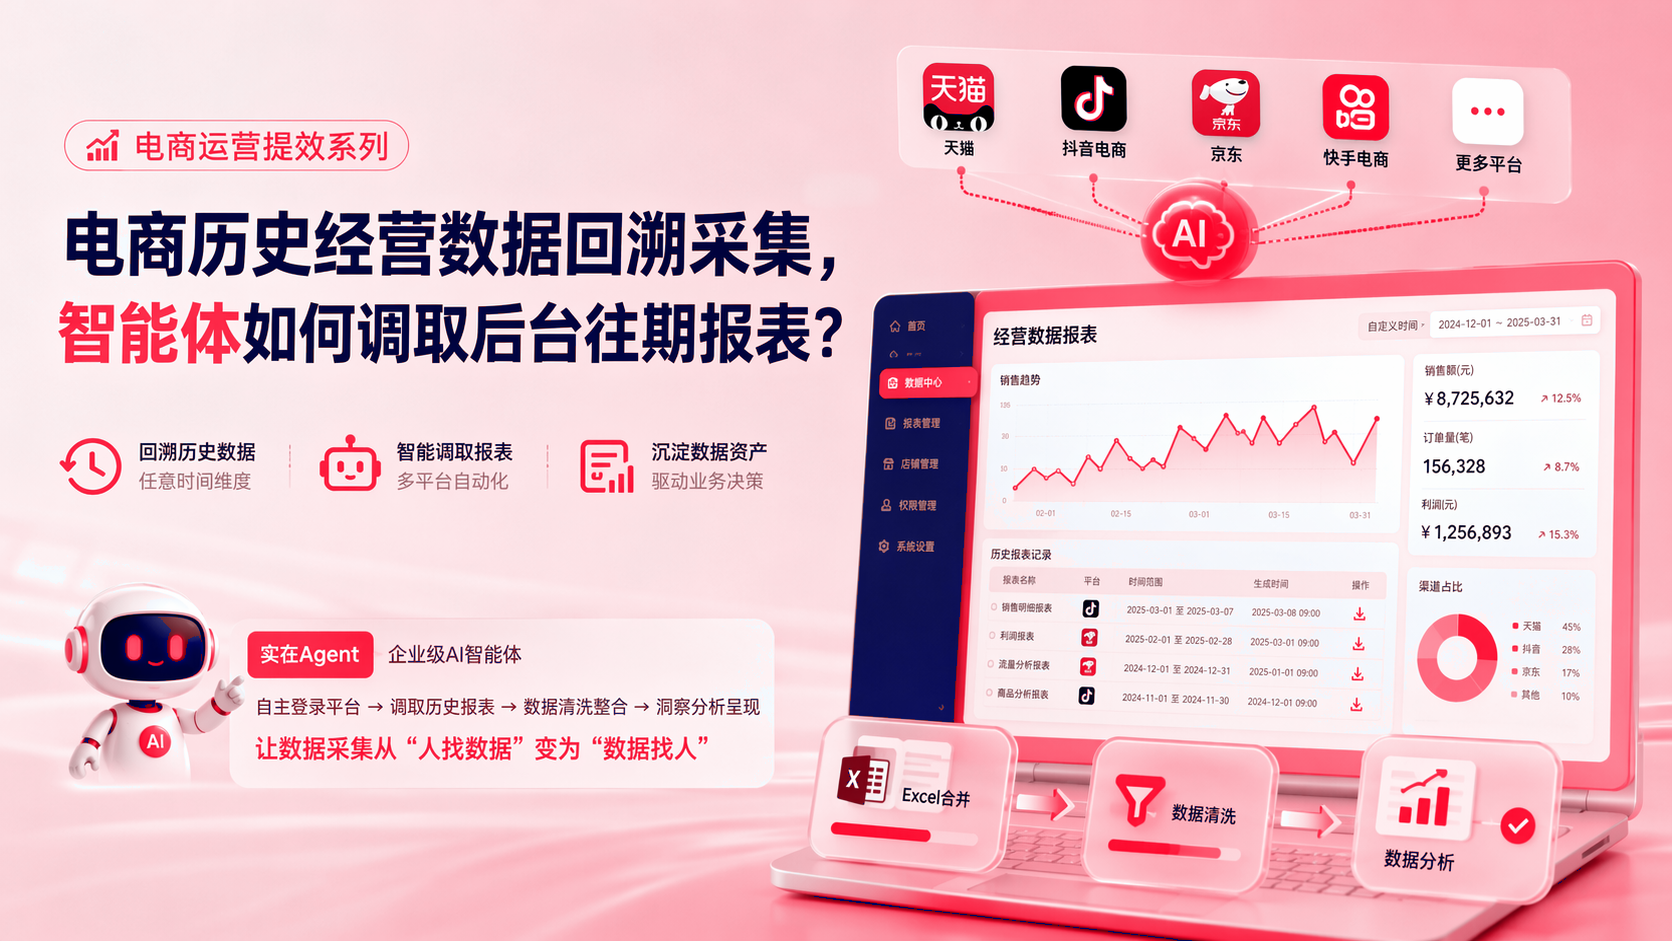
核心痛点:如何判断人工回溯如此痛苦
在电商运营中,“历史经营数据回溯”指的不是简单地下载昨天的报表,而是根据特定需求,回顾过去某段时间(如某次大促、某款新品生命周期)内,分散在不同平台、不同系统后台的订单、利润、流量、库存等结构化数据。
这正是数据驱动决策的“阿喀琉斯之踵”——核心价值数据深埋在操作系统的缝隙里,无法被高效调用。
电商历史经营数据回溯采集的知识与系统准备
时代飞鹰交付的数字员工以电商历史经营数据回溯采集中的高频任务为试点,配置所需知识、权限、审核和告警机制,运行稳定后再连接相邻岗位与上下游系统。
电商历史经营数据回溯采集涉及对外回复、批量写入或业务承诺时,应设置权限分级、人工审核、异常告警和操作留痕,并保留可回退的处理路径。
试运行电商历史经营数据回溯采集时,应保留输入、判断过程、输出结果和人工修订记录。业务人员可据此识别高频异常,调整知识、字段映射和流程分支。
电商历史经营数据回溯采集的运行记录应能对应到任务、时间、输入和处理结果。出现问题时,业务与技术人员可以据此定位环节,而不是重新翻查多个系统。
全链路自动化:走向入库的无人值守所需的流程调整
- 多维筛选与按规则定位:智能体基于自然语言理解,自动进入后台“交易管理”、“经营报表”或“数据看板”模块,并准确设置“时间范围”(如2024年10月1日至2024年10月7日)、“店铺名称”、“数据粒度”(单品级或店铺级)等筛选条件。它还能识别页面上的数据报告模板,区分标准报表与动态看板卡片。
- 标准化入库与异常预警:采集到的所有数据,无论来源平台,都会被统一清洗、映射字段,并自动写入企业内部数据库或BI系统。同时,设任务遇到页面改版、字段缺失等异常,智能体会自动记录问题原因,并通过钉钉/企微及时通知管理员介入,形成闭环。
三. 超越采集:智能体如何重构决策数据闭环
传统的流程是:打电话给数据分析师 → 分析师登录后台 → 导出数据 → 清洗 → 做图表 → 微信传文件。这一套流程走下来,至少需要2-3小时。
长期积累的、被自动采集的历史经营数据,会自然形成一个高价值的数据资产池。这个池子不再是一堆杂乱无章的Excel,而是结构清晰、可被机器学习模型直接调用的“结构化经营知识库”。
- 支持按规则选品:智能体通过对过去三年所有SKU(单品)的销售、退货、毛利数据的交叉分析,能自动推荐“下一季度最具潜力的爆款组合”。
- 赋能研发决策:研发人员不再需要花半天去查找技术文档。通过自然语言提问,智能体可以在“秒级”内从历史千万份研究文献中,检索出最相关的技术指标与数据图谱。
回看电商行业的发展,我们可以清晰地看到一条主线:从“人找货”到“货找人”是第一次革命;而从“人找数据”到“数据找人”,正是正在发生的第二次生产关系重塑。
从单一任务扩展电商历史经营数据回溯采集
验收电商历史经营数据回溯采集不能只看任务是否跑通,还要检查数据口径、权限边界、异常分流、人工审核和操作记录。控制项齐备后,才适合扩展到相邻流程。