

围绕电商评论采集建设智能体,核心问题是数据口径、系统连接和责任边界。输入、判断规则、输出结果与异常路径都定义清楚后,流程才适合进入日常运行。
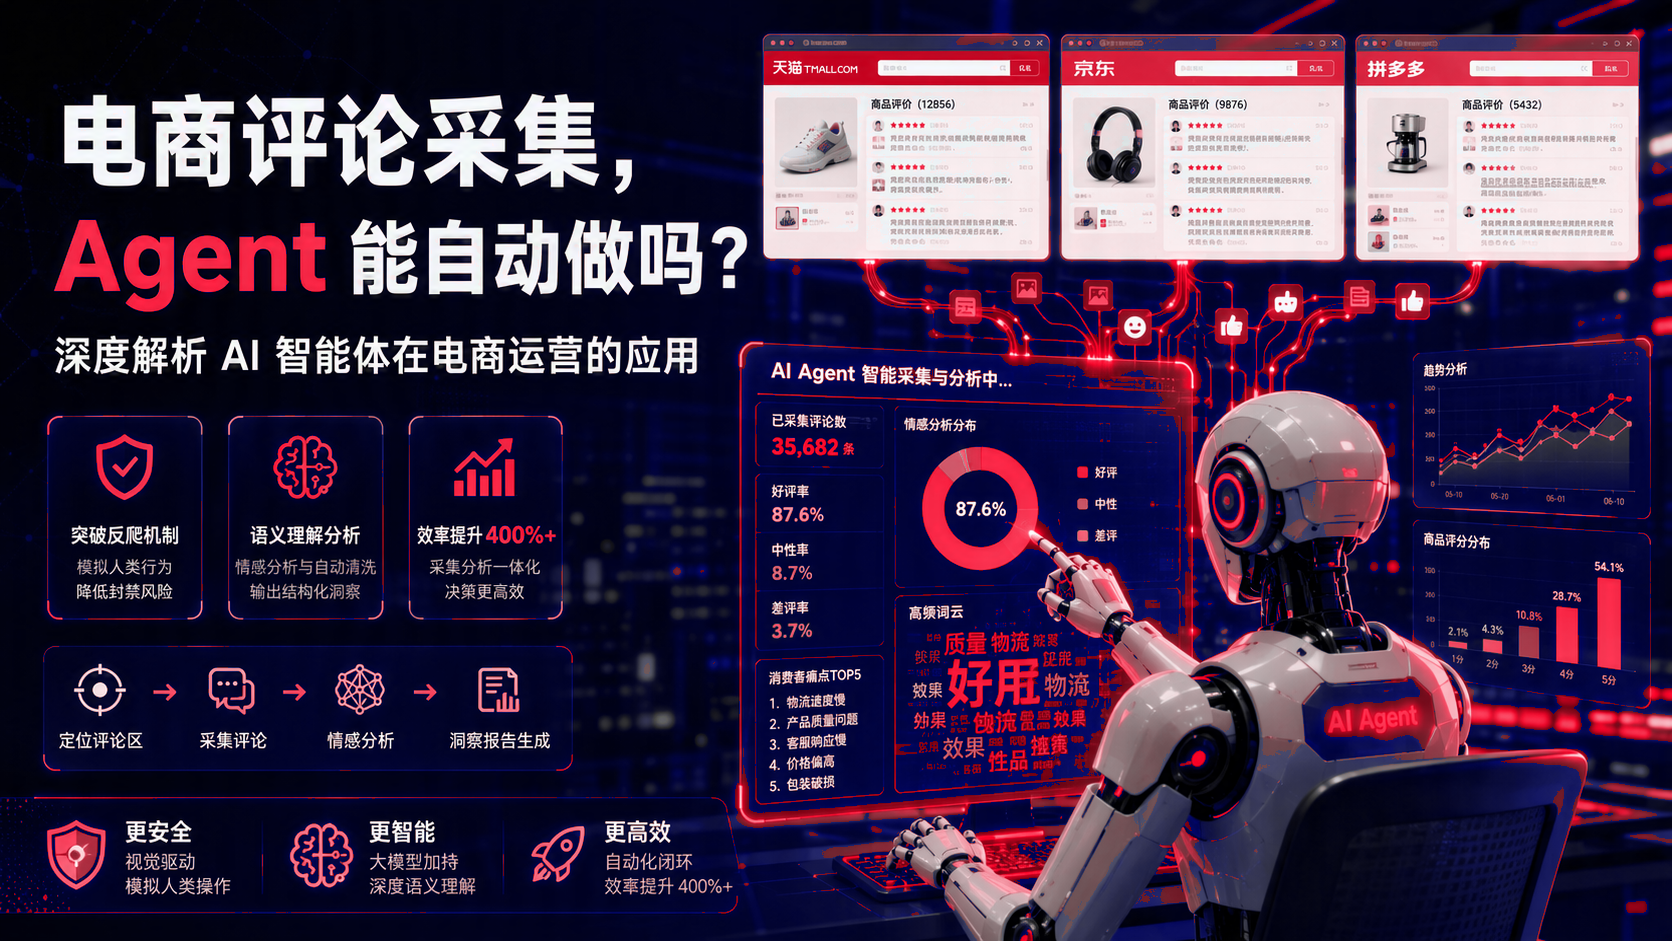
在存量竞争时代,电商评论采集已成为品牌洞察市场、优化产品及监控竞品的核心手段。随着各大平台反爬技术的升级与数据结构的复杂化,传统方案面临巨大挑战。那么,智能体 能自动做吗?答案是肯定的,且 智能体 正在重新定义数据采集的效率边界。
电商评论采集的行业痛点与技术演进
根据相关行业调研,超过 85% 的电商运营决策依赖于对消费者反馈的深度挖掘。然而,传统采集方式正遭遇前境未有的瓶颈:
- 反爬机制严苛:头部平台频繁更新验证策略,传统脚本极易触发封禁。
- 数据非结构化:评论中包含大量口语化表达、表情包及图片,提取核心价值信息的难度大。
- 维护成本高昂:页面布局稍有变动,基于 DOM 结构的爬虫就需要重新编写。
2024年以来,随着大模型技术的成熟,智能体(智能体)的出现为上述难题提供了智能化解法。它不再是机械执行代码,而是具备理解与推理能力的自动化单元。
智能体 自动采集的核心逻辑与优势
相比于传统 流程自动化工具 或 Python 爬虫,智能体 执行采集任务时表现出显著的‘类人’特征:
电商评论采集需要明确的实施边界
时代飞鹰制作的智能体会把电商评论采集拆成可核验的岗位任务,并通过知识增强、系统连接和流程编排处理数据归集、比对、回写与任务流转。具体范围以诊断结果为准。
电商评论采集涉及对外回复、批量写入或业务承诺时,应设置权限分级、人工审核、异常告警和操作留痕,并保留可回退的处理路径。
电商评论采集的系统连接应区分读取、写入和通知动作。读取类任务可先试运行;批量写入、状态变更或对外发送则需增加审批、失败重试和人工接管条件。
为避免电商评论采集在异常情况下持续执行,流程中需要设置停止条件和通知对象。无法识别的数据、超出规则的判断和写入失败都应转入人工待办。
语义识别与自动清洗
在采集过程中,智能体 可同步调用大语言模型对评论进行情感倾向分析。它能自动识别‘好评中的吐槽’或‘差评中的误解’,直接输出结构化的洞察报告,省去了后期繁琐的人工清洗环节。
- 跨平台协同:自动登录淘宝、京东、拼多多等多个平台,统一汇总全网口碑数据。
- 长文本处理:针对数万条评论,利用内置的大模型插件自动生成‘优缺点总结’及‘消费者痛点地图’。
总结与未来趋势
电商评论采集已从‘数据获取’阶段跨越到‘智能理解’阶段。智能体 不仅解决了‘能不能自动做’的问题,更解决了‘做完后如何直接使用’的难题。对于电商企业而言,构建基于智能体的自动化工作流将成为核心竞争力。
Q1: 使用 智能体 采集评论会被封号吗
智能体 采用视觉驱动和模拟人类行为的模式,相比传统协议级爬虫,其隐蔽性更高。通过配置合理的采样频率和行为轨迹,可以最大限度规避封禁风险。
Q2: 智能体 采集后的数据安全如何保障
企业级 智能体 方案通常支持私有化部署,确保采集到的敏感商业竞争数据仅在企业内网流转,符合数据安全合规要求。
除了评论采集,智能体 还可以应用于自动化上架、价格监控、智能客服回复以及跨平台的库存同步等复杂业务逻辑场景。
电商评论采集上线前如何验收
为电商评论采集选择首批任务时,应优先考虑规则清楚、重复频率高且结果可核验的环节。小范围运行后,再根据日志、异常类型和业务反馈更新知识与流程。